Emanuel EJ, Baker-Butler A, Khosla N, Khosla V. Will Autonomous AI Exceed AI-Aided Physicians as the Best Medical Care? JAMA. 2026;336(11):915-918.
El artículo de JAMA que comentamos (de opinión, no un estudio original como es habitual en GCS) viene firmado por Ezekiel Emanuel, un oncólogo y bioético muy influyente en la política sanitaria estadounidense, Abe Baker-Butler, Neal Khosla, consejero delegado de la startup de IA sanitaria Curai Health, y su padre, Vinod Khosla, un billonario gran inversor de capital riesgo con participaciones en OpenAI, Curai Health y Limbic.
Al menos estos dos últimos firmantes tienen un interés directo en la hipótesis del artículo, algo a tener en cuenta al valorar unos argumentos bastante más generosos con la IA de lo que permite la propia evidencia empírica en que los autores se apoyan.
La hipótesis: el médico, sólo o asistido por IA, tiene peores resultados que la IA sola.
Básicamente, los autores sostienen que la IA sola ya iguala o supera al médico (asistido por IA) en cinco tareas cognitivas: recabar información, diagnóstico diferencial, elección de pruebas, tratamiento acorde a guías y gestión de crónicos.
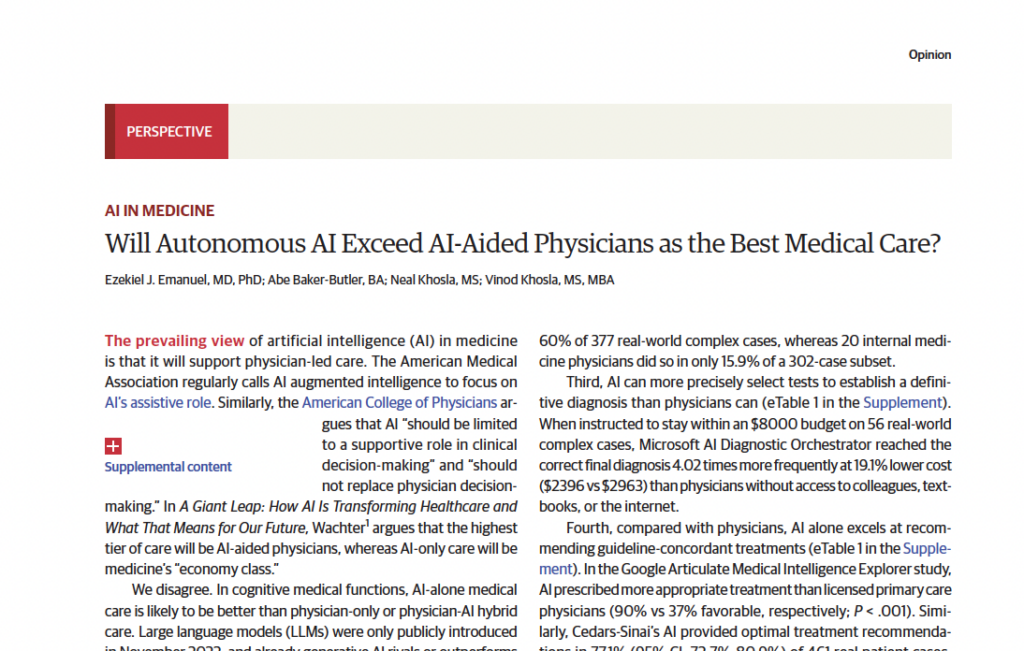
Y de ahí saltan, contra la opinión de la American Medical Association (AMA), el American College of Physicians y la de Robert Wachter, un internista muy influyente en temas de calidad asistencial y autor de un conocido texto sobre la IA en medicina, a que meter al médico «en el bucle» empeora el resultado frente a la IA autónoma. No es que el «humano» deje de ser relevante en la toma de decisiones sino que las empeoraría.
¿Qué «evidencia» sustenta la hipótesis?
La argumentación de los autores se apoya fundamentalmente en tres trabajos. El primero, el estudio de Google AMIE, el sistema de IA conversacional de Google DeepMind diseñado específicamente para diagnóstico médico. Es un ensayo cruzado aleatorizado y doble ciego, con 159 casos simulados (pacientes actores) en Canadá, Reino Unido e India, siguiendo el formato estándar de evaluación de habilidades clínicas usado en las facultades de medicina y en los exámenes de especialización de algunos países (Objective Structured Clinical Examination, OSCE). El estudio compara los resultados de AMIE con los de 20 médicos de atención primaria y la IA superó a los médicos en precisión diagnóstica en todos los puntos de medición. Pese al diseño, es un simulacro. Con actores entrenados siguiendo un guion, no pacientes reales con ambigüedad clínica genuina.
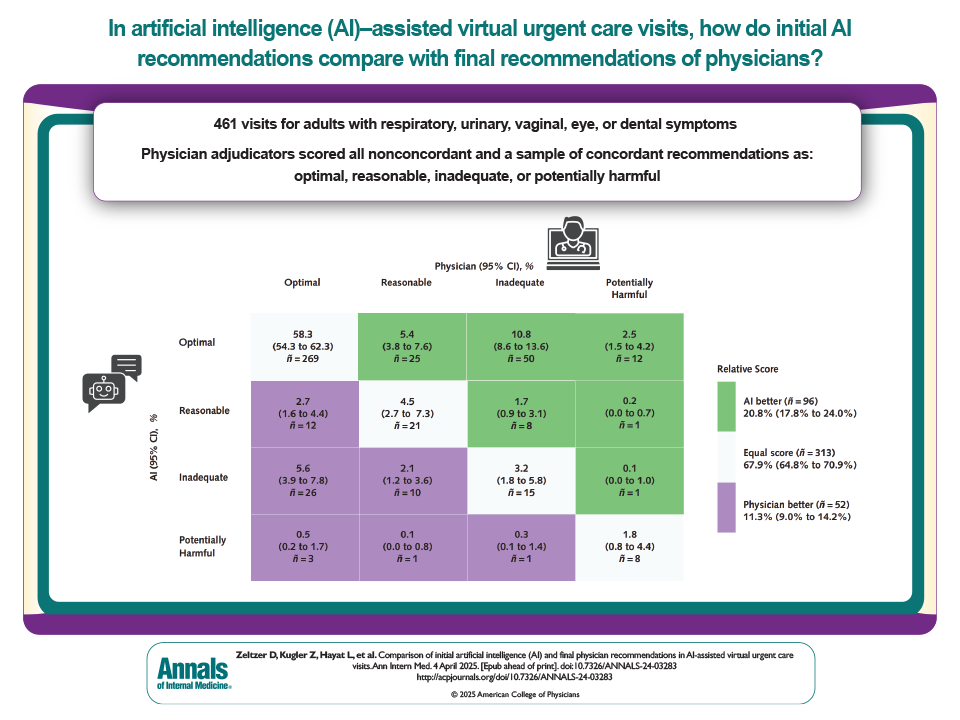
El segundo estudio, un análisis de 461 visitas a un servicio de teleconsulta ambulatoria de urgencias, un panel de cuatro médicos expertos puntuó la calidad de la recomendación inicial generada por la IA (77,1% óptimas) frente a la recomendación final del médico que atendió el caso y tenía acceso -aunque no necesariamente revisó- a los resultados de la IA (67,1% óptimas). Los autores de este trabajo señalan que no se valoró que médicos revisaron las recomendaciones de la IA o en qué medida se apoyaron en ellas, y precisan que el estudio «solo midió la exactitud de las recomendaciones del algoritmo, no su impacto en los médicos». No es una comparación limpia de IA sola contra médico solo, ni un híbrido diseñado como trabajo colaborativo deliberado.
El tercer trabajo, un metaanálisis de híbridos humano-IA, aporta un hallazgo real y bien cuantificado: cuando la IA-sola ya superaba al humano-solo, los híbridos empeoraban el resultado; cuando el humano superaba a la IA, los híbridos mejoraban. Pero muy pocos estudios de ese metaanálisis eran de medicina (el grueso se refería a ajedrez, previsión, juicio de imágenes no clínicas, …) y generalizar ese hallazgo al conjunto de la práctica clínica es un tanto excesivo.
Los ensayos que miden desenlaces reales
Cuando se sale del simulacro y se entra en el ensayo clínico con pacientes de carne y hueso, las cosas no parecen igual. Por ejemplo, DDX-BRO, un ensayo cruzado aleatorizado por clúster en varios servicios de urgencias, no encontró diferencia en el riesgo de diagnóstico deficiente entre apoyo computarizado y diagnóstico convencional.
LungIMPACT, un ensayo en varios hospitales del NHS británico, sobre 93.326 radiografías de tórax, no cambió el tiempo a TC, a diagnóstico, a tratamiento ni el estadio al diagnóstico pese a la buena sensibilidad y especificidad de la IA por separado.
Aunque la literatura sobre el impacto de la IA en los resultados para los pacientes suele ser débil y con alto riesgo de sesgo de publicación, el contraste es consistente: cuanto más simulado y acotado el escenario, mejor rinde la IA; cuanto más real el estudio (pacientes de verdad, flujo de trabajo habitual, desenlaces clínicos en vez de precisión diagnóstica aislada) más se diluye la ventaja.
La paradoja del deskilling
Hay un segundo problema en el argumento. Los autores reconocen que «las capacidades de los médicos están amenazadas por el deskilling inducido por la IA» pero extraen conclusiones paradójicas. Para referirse al deskilling se apoyan en un trabajo en que la tasa de detección de adenomas en colonoscopias realizadas sin IA cayó cuando los endoscopistas empezaran a usar IA de forma habitual. Los mismos profesionales, haciendo el mismo procedimiento sin ayuda de IA, diagnosticaban peor tras un periodo de trabajar habitualmente con IA.
Curiosamente, este trabajo se cita para argumentar que la brecha entre médicos e IA se ensanchará y por tanto conviene acelerar la transición a la IA sola. Pero retirar al médico del bucle porque la IA acelera el deterioro de la habilidad humana, vuelve el argumento circular (y autocumplido). Cuanta menos práctica activa y sin apoyo tenga un profesional, peor será su rendimiento.
Y el deskilling no es un detalle menor cuando los propios autores admiten que la IA falla de forma distinta al médico (alucinaciones, pérdida de conectividad, ciberataques) y que esos riesgos serán mayores en la IA autónoma que en los híbridos. Un sistema sanitario que deje deteriorarse deliberadamente la pericia de sus profesionales no tendrá red de seguridad cuando la IA falle en esos casos que un médico entrenado sí habría detectado.
¿Qué significa esto para el SNS?
Nada de esto se traduce automáticamente al contexto español, pero el mensaje de fondo sí interpela directamente a cómo se están desplegando las herramientas de apoyo diagnóstico y de decisión en el SNS.
Primero, conviene empezar a distinguir entre rendimiento en tareas simuladas o retrospectivas y rendimiento en pacientes reales. Son cosas distintas y, pese a los discursos de los «innovadores» interesados, no deberían tratarse como intercambiables.
Segundo, el riesgo de deskilling debería incorporarse en cualquier programa de despliegue de IA en formación médica y especializada. Mantener rotaciones y evaluaciones periódicas de rendimiento sin apoyo de IA parece una salvaguarda razonable y barata frente a un riesgo ya documentado.
Tercero, y de forma más general, la brecha entre lo que promete un titular y lo que sostiene el diseño del estudio que hay detrás exige la misma lectura crítica que aplicaríamos a un estudio con cualquier medicamento.
Lo llamativo del trabajo no es tanto que equivoquen el diagnóstico (probablemente la IA puede rendir mejor en algunas tareas cognitivas acotadas) sino la distancia entre la contundencia de sus conclusiones y la fragilidad de la base empírica que las sostiene.
Referencias
- Emanuel EJ, Baker-Butler A, Khosla N, et al. Will Autonomous AI Exceed AI-Aided Physicians as the Best Medical Care? JAMA. 2026;336(11):915-918.
- Tu T, Schaekermann M, Palepu A, et al. Towards conversational diagnostic artificial intelligence. Nature. 2025;642(8067):442-450.
- Zeltzer D, Goldzweig C, et al. Comparison of Initial Artificial Intelligence (AI) and Final Physician Recommendations in AI-Assisted Virtual Urgent Care Visits. Ann Intern Med. 2025;178(4):498-506.
- Vaccaro M, Almaatouq A, Malone T. When combinations of humans and AI are useful: a systematic review and meta-analysis. Nat Hum Behav. 2024;8(12):2293-2303.
- Hautz WE, Marcin T, Hautz SC, et al. Diagnoses supported by a computerised diagnostic decision support system versus conventional diagnoses in emergency patients (DDX-BRO): a multicentre, multiple-period, double-blind, cluster-randomised, crossover superiority trial. Lancet Digit Health. 2025;7(2):e136-e144.
- Woznitza N, Smith L, Rawlinson J, et al. AI-based chest X-ray prioritization in the lung cancer diagnostic pathway: the LungIMPACT randomized controlled trial. Nat Med. 2026;32(5):1737-1744.
- Budzyń K, Romańczyk M, Kitala D, et al. Endoscopist deskilling risk after exposure to artificial intelligence in colonoscopy: a multicentre, observational study. Lancet Gastroenterol Hepatol. 2025;10(10):896-903.